Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Problem Management
Top-Angebote
Produkte zum Begriff Problem Management:
-
Hebing, Marcel: Data Science ManagementData Science Management , Vom ersten Konzept bis zur Governance datengetriebener Organisationen , Federungsset > Sportfederung , Erscheinungsjahr: 20240131, Produktform: Kartoniert, Titel der Reihe: Animals##, Autoren: Hebing, Marcel~Schmidt, Martin, Seitenzahl/Blattzahl: 288, Keyword: AIOps; Agile; Analytics Continuum; Data Science; Data Science Architekturen; Data Science Lebenszyklus; Data Science Lifecycle; DataOps; Datenanalyse; Datenmanagement; DevOps; Governance. Proof of Concept; MLOps; Machine Learning; Statistik; agiles Projektmanagement, Fachschema: Data Mining (EDV), Warengruppe: HC/Informatik/EDV/Sonstiges, Fachkategorie: Data Mining, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Dpunkt.Verlag GmbH, Verlag: Dpunkt.Verlag GmbH, Verlag: O'Reilly, Produktverfügbarkeit: 02, Länge: 240, Breite: 165, Höhe: 18, Gewicht: 574, Produktform: Klappenbroschur, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0018, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,34,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Strengholt, Piethein: Data Management at ScaleData Management at Scale , Modern Data Architecture with Data Mesh and Data Fabric , > , Auflage: 2nd Edition, Erscheinungsjahr: 202305, Produktform: Kartoniert, Autoren: Strengholt, Piethein, Auflage: 23002, Auflage/Ausgabe: 2nd Edition, Themenüberschrift: COMPUTERS / Web / Web Services & APIs~COMPUTERS / Data Modeling & Design~COMPUTERS / Cloud Computing, Fachschema: Architektur (EDV)~Rechnerarchitektur~Data Mining (EDV)~Analyse / Datenanalyse~Datenanalyse~Database~Datenbank~Datenverarbeitung / Simulation~Microsoft SharePoint (WebServices, Portal)~Web Services (EDV)~Cloud Computing, Fachkategorie: Datenbankdesign und -theorie~Cloud Computing~Computermodellierung und -simulation~Informationsarchitektur, Warengruppe: HC/Informatik, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 232, Breite: 179, Höhe: 25, Gewicht: 705, Produktform: Kartoniert, Genre: Importe,60,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
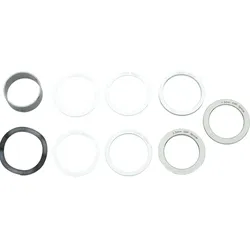
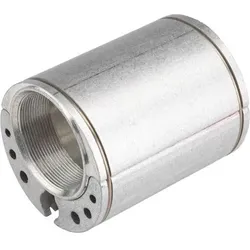
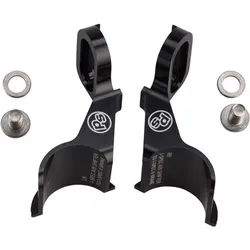
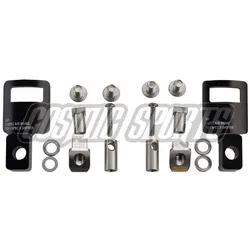
Problem Solvers, Zubehör VelobremsenDie ReMatch-Adapter von Problem Solver ermöglichen es dem Fahrer, verschiedene Generationen von Shimano I-Spec-Komponenten auf einer Klemme zu montieren. I-Spec A, I-Spec B, I-Spec II - egal welche Kombination du brauchst, es gibt sie. • Typ: Klemmschelle • Material: AL-6061 Aluminium • Kompatibilität: Shimano I-Spec II Bremsen mit Shimano I-Spec A/B Shifter • Bauart: Adapter zum Kombinieren verschiedener Shimano I-Spec Komponenten • Geeignet für: Scheibenbremse • Details: Nicht kompatibel mit Deore M610 oder SLX M670 Shifter.108,05 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Wie kann ein effektives Problem Management dazu beitragen, die geschäftlichen Abläufe zu verbessern?
Ein effektives Problem Management kann dazu beitragen, wiederkehrende Probleme zu identifizieren und langfristige Lösungen zu implementieren. Dadurch werden Ausfallzeiten reduziert und die Produktivität gesteigert. Zudem können Kunden zufriedener sein, da ihre Probleme schneller und effizienter gelöst werden. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Top-Angebote
Produkte zum Begriff Problem Management:
-
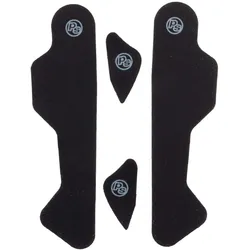
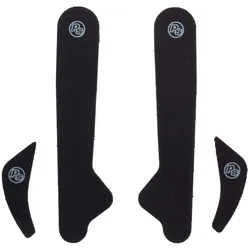
Problem Solvers, Zubehör VelobremsenDie Lever Grippies von Problem Solvers sind speziell entwickelte Brems- und Schalthebel-Sticker, die eine verbesserte Griffigkeit bieten. Diese Zubehörteile sind ideal für Radfahrer, die ihre Kontrolle und Sicherheit beim Fahren erhöhen möchten. Die Griptape-Oberfläche sorgt dafür, dass die Hände auch bei nassen oder schweisstreibenden Bedingungen einen festen Halt haben. Die Lever Grippies sind kompatibel mit den Shimano Road Modellen R7000, R8000 und R9000 und eignen sich hervorragend für Fahrräder mit Scheibenbremsen. Im Lieferumfang sind vier Sticker enthalten, die eine einfache Anbringung ermöglichen und eine individuelle Anpassung der Bremshebel bieten. - Verbesserte Griffigkeit durch spezielle Griptape-Oberfläche - Kompatibel mit Shimano Road R7000/8000/9000 - Einfach anzubringen mit vier enthaltenen Stickern.42,39 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Hebing, Marcel: Data Science ManagementData Science Management , Vom ersten Konzept bis zur Governance datengetriebener Organisationen , Federungsset > Sportfederung , Erscheinungsjahr: 20240131, Produktform: Kartoniert, Titel der Reihe: Animals##, Autoren: Hebing, Marcel~Schmidt, Martin, Seitenzahl/Blattzahl: 288, Keyword: AIOps; Agile; Analytics Continuum; Data Science; Data Science Architekturen; Data Science Lebenszyklus; Data Science Lifecycle; DataOps; Datenanalyse; Datenmanagement; DevOps; Governance. Proof of Concept; MLOps; Machine Learning; Statistik; agiles Projektmanagement, Fachschema: Data Mining (EDV), Warengruppe: HC/Informatik/EDV/Sonstiges, Fachkategorie: Data Mining, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Dpunkt.Verlag GmbH, Verlag: Dpunkt.Verlag GmbH, Verlag: O'Reilly, Produktverfügbarkeit: 02, Länge: 240, Breite: 165, Höhe: 18, Gewicht: 574, Produktform: Klappenbroschur, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0018, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,34,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Strengholt, Piethein: Data Management at ScaleData Management at Scale , Modern Data Architecture with Data Mesh and Data Fabric , > , Auflage: 2nd Edition, Erscheinungsjahr: 202305, Produktform: Kartoniert, Autoren: Strengholt, Piethein, Auflage: 23002, Auflage/Ausgabe: 2nd Edition, Themenüberschrift: COMPUTERS / Web / Web Services & APIs~COMPUTERS / Data Modeling & Design~COMPUTERS / Cloud Computing, Fachschema: Architektur (EDV)~Rechnerarchitektur~Data Mining (EDV)~Analyse / Datenanalyse~Datenanalyse~Database~Datenbank~Datenverarbeitung / Simulation~Microsoft SharePoint (WebServices, Portal)~Web Services (EDV)~Cloud Computing, Fachkategorie: Datenbankdesign und -theorie~Cloud Computing~Computermodellierung und -simulation~Informationsarchitektur, Warengruppe: HC/Informatik, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 232, Breite: 179, Höhe: 25, Gewicht: 705, Produktform: Kartoniert, Genre: Importe,60,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Wie kann ein effektives Problem Management dazu beitragen, die geschäftlichen Abläufe zu verbessern?
Ein effektives Problem Management kann dazu beitragen, wiederkehrende Probleme zu identifizieren und langfristige Lösungen zu implementieren. Dadurch werden Ausfallzeiten reduziert und die Produktivität gesteigert. Zudem können Kunden zufriedener sein, da ihre Probleme schneller und effizienter gelöst werden. **
Ähnliche Suchbegriffe für Problem Management
-
Problem Solvers, Zubehör VelobremsenDie ReMatch-Adapter von Problem Solver ermöglichen es dem Fahrer, verschiedene Generationen von Shimano I-Spec-Komponenten auf einer Klemme zu montieren. I-Spec A, I-Spec B, I-Spec II - egal welche Kombination du brauchst, es gibt sie. • Typ: Klemmschelle • Material: AL-6061 Aluminium • Kompatibilität: Shimano I-Spec II Bremsen mit Shimano I-Spec A/B Shifter • Bauart: Adapter zum Kombinieren verschiedener Shimano I-Spec Komponenten • Geeignet für: Scheibenbremse • Details: Nicht kompatibel mit Deore M610 oder SLX M670 Shifter.108,05 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Problem Solvers, Zubehör VelobremsenDie ReMatch-Adapter von Problem Solver ermöglichen es dem Fahrer, verschiedene Generationen von Shimano I-Spec-Komponenten auf einer Klemme zu montieren. I-Spec A, I-Spec B, I-Spec II - egal welche Kombination du brauchst, es gibt sie. • Typ: Klemmschelle • Material: AL-6061 Aluminium • Kompatibilität: Shimano I-Spec A/B Bremsen mit Shimano I-Spec II Shifter • Bauart: Adapter zum Kombinieren verschiedener Shimano I-Spec Komponenten • Geeignet für: Scheibenbremse.97,84 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Problem Solvers, Zubehör VelobremsenDie Lever Grippies von Problem Solvers sind speziell entwickelte Brems- und Schalthebel-Sticker, die eine verbesserte Griffigkeit bieten. Diese Zubehörteile sind ideal für Radfahrer, die ihre Kontrolle und Sicherheit beim Fahren erhöhen möchten. Die Griptape-Oberfläche sorgt dafür, dass die Hände auch bei nassen oder schweisstreibenden Bedingungen einen festen Halt haben. Die Lever Grippies sind mit Shimano Road Di2 kompatibel und eignen sich hervorragend für Fahrräder mit Scheibenbremsen. Im Lieferumfang sind vier Sticker enthalten, die einfach anzubringen sind und eine langlebige Lösung für eine verbesserte Ergonomie bieten. Diese Zubehörteile sind eine praktische Ergänzung für jeden Fahrradliebhaber, der Wert auf Sicherheit und Komfort legt. - Griptape-Oberfläche für verbesserte Griffigkeit - Kompatibel mit Shimano Road Di2 - Einfach anzubringen und langlebig.42,39 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.